 E-commerce
 Abonnementssystemen
 Chatbot
 Online cursussen
 Reservering
 Reisgids
 Evenementen
 Content creators
 Lokale bezorging en afhalen
 Kranten
 Radio
 Scholen
 Religie
 Organisaties
 Restaurant
 Boodschappen
 Zelf bouwen
 Interne communicatie


 GEEN CODE APP BOUWER
 TECHNOLOGIE
 WAAROM GOODBARBER?
 Ontwerp
 PRODUCTBRONNEN
 ONDERWERPEN

 RESELLERS VAN MOBIELE APPS
 ONTDEK
Lezen AI-agents Markdown? Wat twee weken logs van onze eigen server vertellen
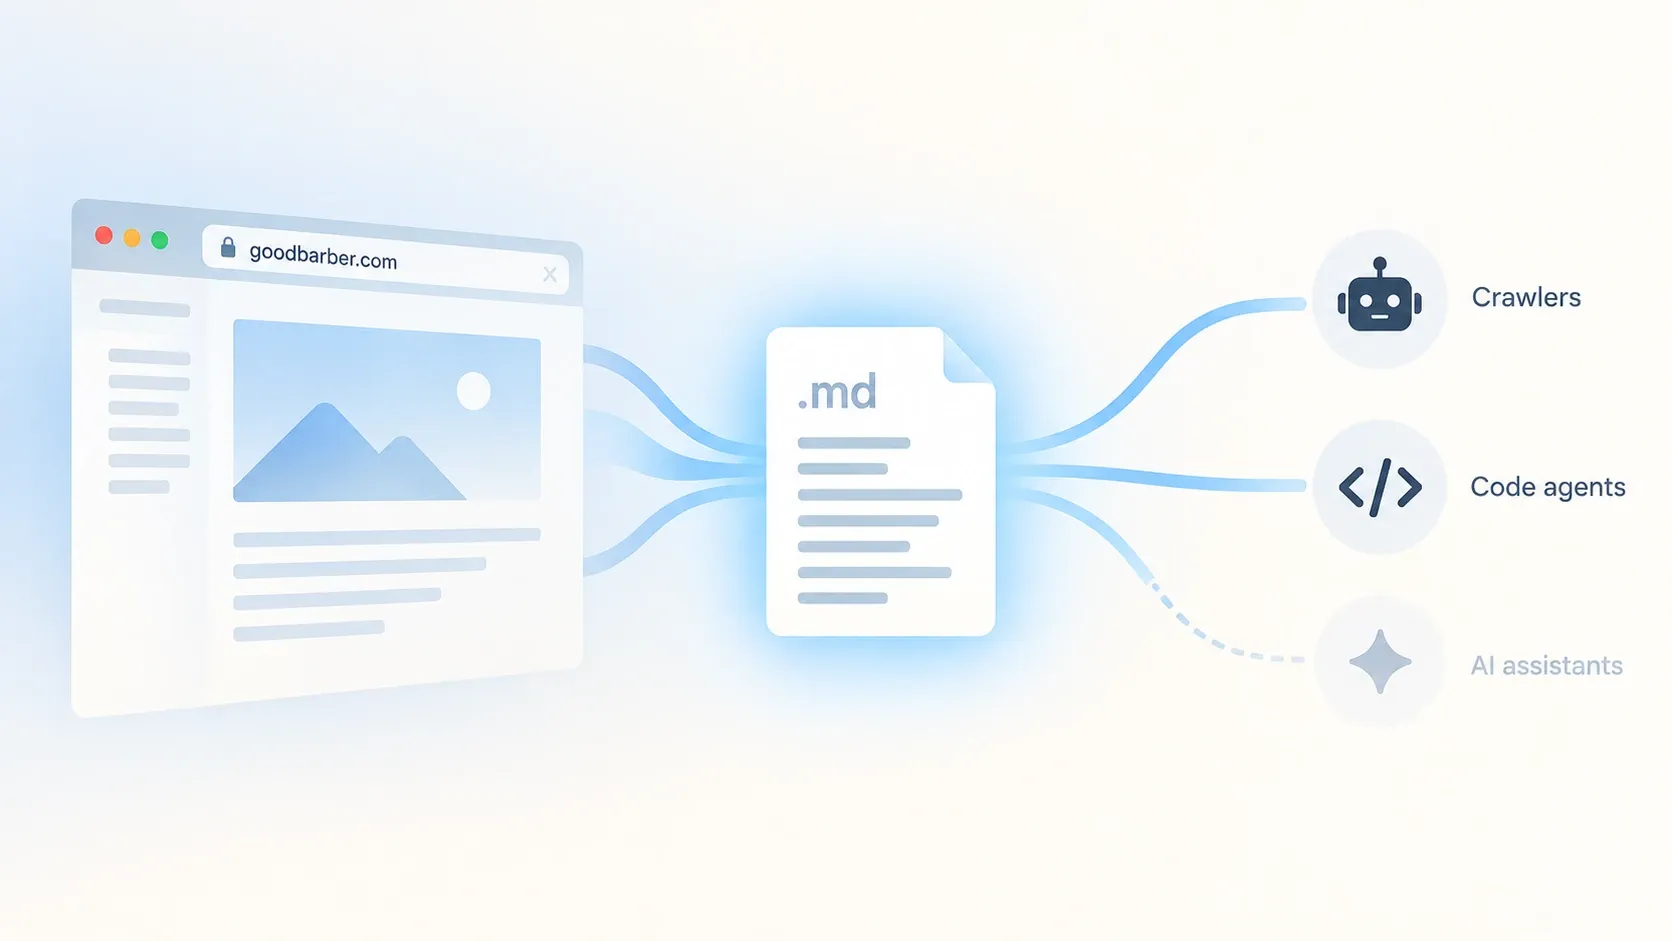
Begin september 2026 hebben we elke pagina van ons eigen commerciële portaal, dat u op dit moment bekijkt, een Markdown-tweeling gegeven: vraag erom en u krijgt de pagina als schone tekst in plaats van HTML. Daarna hebben we de logs gelezen. Crawlers pikten hem op, codeeragents vroegen er uitdrukkelijk om, en de assistenten die vragen van mensen beantwoorden, lieten hem volledig links liggen. Dit is wat we hebben gemeten, met datum erbij, en wat u ervan kunt gebruiken voor uw eigen content.
Under the hood — de techniek achter GoodBarber, uitgelegd aan de mensen die apps draaiend houden.
Even het kader schetsen: alles wat hieronder staat, speelde zich af op ons eigen commerciële portaal, en ons eigen team heeft het opgezet. Wat we hebben geleerd over de machines die webpagina's lezen, geldt voor alle content, die van ons en die van u.
In het kort, gemeten op ons portaal van 4 tot 18 september 2026:
- De crawlers van AI-bedrijven (Amazon, Meta, OpenAI) die trainingsdata verzamelen en indexen bouwen, hebben de Markdown-pagina's gelezen via de
.md-link: zo'n 80.000 verzoeken in twee weken. - Codeeragents, Claude Code voorop, vragen om Markdown met de header
Accept: text/markdownen krijgen het ook: zo'n 22.000 verzoeken met die header, bijna allemaal van antwoordmachines voor AI-agents en van Claude Code. - ChatGPT, Claude op het web en Perplexity hebben, wanneer ze een persoon antwoorden, de HTML meer dan 13.000 keer opgehaald en de Markdown één keer.
- De crawler van Google heeft geen enkele Markdown-pagina opgevraagd.
- Markdown weegt zo'n 80% minder dan de HTML-pagina waar het uit komt.
Waarom Markdown serveren aan AI-agents
GoodBarber is een no-codeplatform om mobiele apps mee te bouwen; goodbarber.com is de commerciële website ervan, in elf talen, met marketingpagina's, een blog en een helpcentrum. Wanneer iemand aan een AI-assistent vraagt of GoodBarber de app kan bouwen die hij in gedachten heeft, leest die assistent niet onze brochure. Hij haalt onze pagina's op, soms duizenden per dag, en perst een antwoord uit de HTML. HTML is zwaar: menu's, scripts, opmaak, cookiebanners. Markdown is de tekst van de pagina en verder niets. Die serveren wanneer een machine erom vraagt, betekent dat de assistent de echte inhoud leest, sneller, in een fractie van de omvang, met minder kans dat hij het over ons bij het verkeerde eind heeft.
In augustus 2026 had Pierre-Laurent geteld wie onze llms.txt leest. Een llms.txt is een tekstbestand in de root van een website dat de belangrijke pagina's ervan opsomt voor AI-systemen: in vier maanden was geen enkele assistent er uit zichzelf naar op zoek gegaan. Dezelfde logs lieten nog iets anders zien: in diezelfde periode hadden assistenten en hun crawlers onze gewone pagina's 1,6 miljoen keer opgehaald. Niemand leest de plattegrond; iedereen loopt door de straten. De vraag was dus niet "hoe krijgen we ze zover dat ze de index lezen", maar "wat geven we ze in handen als ze aankomen".
Hoe ons portaal Markdown serveert: content negotiation en .md-URL's
Twee deuren, geen dubbele content. De eerste is content negotiation, het standaardmechanisme van het web waarmee een client in zijn verzoek aangeeft welk formaat hij het liefst ontvangt: een client die de header Accept: text/markdown meestuurt, krijgt op hetzelfde adres de Markdown-versie van elke openbare pagina. De tweede is een tweelingadres: een client die .md achter het adres van een pagina zet, /pricing.md, /blog/<artikel>.md, krijgt hetzelfde. Ook deze pagina heeft een tweeling: zet .md achter het adres. Elke HTML-pagina kondigt die tweeling aan met een standaardlink, net zoals ze haar vertalingen aankondigt. De Markdown wordt gegenereerd uit exact de HTML die de pagina al serveert, en kan dus nooit iets zeggen wat de pagina niet zegt; bovendien vraagt hij zoekmachines om hem niet te indexeren: de HTML-pagina blijft de enige die in Google staat.
Voordat we het inschakelden, was de test of een menselijke bezoeker er iets van kon merken: de antwoorden byte voor byte vergeleken met de tweeling aan en uit, in elk type browser dat we maar konden bedenken, identiek, voor een paar microseconden extra per verzoek.
Niets hiervan hebben we zelf bedacht. Cloudflare zet sinds februari 2026 pagina's aan de rand van zijn netwerk om naar Markdown, Zapier en Vercel serveren beide deuren op hun eigen sites. Beheert u een website en wilt u hetzelfde, dan kost dat een dag werk aan de serverkant, een conversiebibliotheek, een cache en een manier om te controleren dat er voor mensen niets is veranderd. Wat bijna niemand doet, is de stap daarna: tellen.
Lezen AI-crawlers Markdown?
Van 4 tot 18 september 2026 hebben twee aparte logs elk verzoek om een Markdown-pagina vastgelegd, op onze elf taalsites, met ons eigen verkeer eruit gefilterd. Elke "wie" hieronder is een opgegeven naam die is gecontroleerd aan de hand van de IP-adressen die de beheerder ervan publiceert, zoals Pierre-Laurent dat ook deed; waar een beheerder niets publiceert, blijft het bij wat de bot zelf opgeeft.
Ja, en zij zijn degenen die de .md-link gebruiken: zo'n 80.000 verzoeken in twee weken. De helft komt van de crawlers van AI-bedrijven, de crawlers die trainingssets en zoekindexen opbouwen: die van Amazon, van Meta, van OpenAI, allemaal vanaf hun gepubliceerde IP-adressen. De crawlers van OpenAI vinden de .md-versie omdat onze HTML-pagina ernaar verwijst: in 99 van de 100 gevallen had dezelfde crawler de HTML-pagina in de tien minuten ervoor opgehaald. De crawler van Bing kwam ook langs, al bracht hij het grootste deel van zijn bezoek door op onze interne zoekpagina's, die antwoord geven op elke zoekopdracht die wie dan ook intypt. De eigen crawler van Google heeft geen enkele Markdown-pagina opgevraagd.
Sturen codeeragents Accept: text/markdown mee?
Ja, vrijwel systematisch. Via de header kwamen zo'n 22.000 verzoeken binnen, een kwart van wat de link kreeg, en van een ander publiek. Bijna alles komt van twee zoekmachines die voor AI-agents zijn gebouwd, ShapBot en ExaSearchBot, en van één codeeragent: Claude Code, de tool die ontwikkelaars, en anderen, op hun eigen computer draaien. Claude Code stuurde de header mee bij vrijwel elk van zijn ruwweg 1.400 paginaverzoeken en kreeg 98 van de 100 keer Markdown terug, driekwart daarvan op ons helpcentrum. Dat strookt met wat Checkly in februari 2026 heeft gemeten: Claude Code, Cursor en OpenCode sturen de header mee; Codex, Gemini CLI, Copilot en Windsurf niet.
Halen ChatGPT, Claude en Perplexity Markdown op?
Nee, via geen van beide deuren. Op dit cijfer hadden we verkeerd gegokt. In twee weken hebben de verzoeken die ontstonden doordat iemand ChatGPT een vraag stelde, meer dan 10.000 van onze HTML-pagina's opgehaald en één enkele Markdown-pagina, drie minuten na de lancering, hoogstwaarschijnlijk een van ons die aan het testen was. Claude op het web: zo'n 2.700 HTML-pagina's, nul Markdown. Perplexity: zo'n 900, nul. Ze halen de HTML-pagina op en schonen die zelf op. Niets van wat wij serveren verandert daar iets aan.
Wie leest wat, en waarvoor:
| Agent (opgegeven) | Wat hij met de pagina doet | HTML | .md-link | Accept-header |
|---|---|---|---|---|
| Amazonbot, Meta-ExternalAgent | crawlt voor trainingsdata | ja | ja, uit zichzelf | nee |
| ClaudeBot | crawlt voor trainingsdata | ja | ja, ongeveer vier .md per tien HTML-pagina's | nee |
| GPTBot | crawlt voor trainingsdata | ja | ja, via de link op onze pagina | nee |
| OAI-SearchBot | bouwt de zoekindex van ChatGPT | ja | ja, via de link op onze pagina | nee |
| PerplexityBot | bouwt de index van Perplexity | ja | nee | nee |
| Bingbot, Applebot, Baidu | klassieke zoekindex | ja | ja (Bing vooral op zoekpagina's) | nee |
| Googlebot | klassieke zoekindex | ja | nee | nee |
| ShapBot, ExaSearchBot | index voor de antwoorden van AI-agents | ja | nee | ja, bij bijna elk verzoek |
| Claude Code | codeeragent, haalt op wat hij nodig heeft | ja | nee | ja, bij vrijwel elk verzoek |
| ChatGPT-User, Claude-User, Perplexity-User | haalt een pagina op om de vraag van een persoon te beantwoorden | ja | nee (één verzoek in twee weken) | nee |
Twee kleinere feiten. Markdown weegt zo'n 80% minder dan de HTML-pagina waar het uit komt, en op het helpcentrum bijna 85%. En nog voor we ook maar één regel Markdown serveerden, stonden er in onze logs al zo'n 900 verzoeken naar .md-adressen die niet bestonden, README.md, agents.md, CLAUDE.md, geprobeerd door tools die verwachten dat een website een coderepository is; een daarvan had precies de adressen geraden die we een maand later publiceerden.
Wat dit betekent voor uw content
Drie dingen, uit onze eigen logs en niet uit iemands slides.
Uw HTML is wat assistenten lezen. ChatGPT, Claude en Perplexity halen de pagina op die een persoon te zien krijgt. Een schone, actuele, goed gestructureerde pagina is wat bij hen aankomt; een Markdown-tweeling niet, in elk geval vandaag niet. Pierre-Laurent schreef hoe u de content corrigeert die assistenten citeren wanneer ze het mis hebben over uw bedrijf; dat werk gaat over de HTML, en dat is het werk dat loont.
Crawlers volgen de links die u publiceert. De crawlers van OpenAI namen de .md-link omdat de pagina hem aanbood. Wijst u crawlers ergens heen, dan gaan ze erheen. Daarom is een llms.txt ook nog steeds de moeite waard: sinds onze pagina's ernaar linken, komen de crawlers van OpenAI er via onze eigen site terecht, waar ze hem vroeger via directory's van derden vonden.
Codeeragents vragen uitdrukkelijk om Markdown. Als ontwikkelaars tot uw publiek behoren, sturen de agents die zij draaien Accept: text/markdown mee en gebruiken ze wat ze terugkrijgen. Ons helpcentrum is waar ze naartoe gingen.
Heeft u een GoodBarber-app, dan is de webversie ervan al de pagina die een assistent kan ophalen en citeren, en met GoodBarber MCP kan een assistent u helpen die content actueel te houden. De pagina's die assistenten werkelijk lezen, zijn de pagina's die u al publiceert.
Veelgestelde vragen
Geldt dit ook voor apps die met GoodBarber zijn gebouwd?
Niet rechtstreeks: dit artikel gaat over ons eigen portaal. Wat nu al voor uw app geldt, is de les: assistenten lezen de HTML-pagina die een persoon te zien krijgt, dus die content actueel houden is wat telt.
Is de website van GoodBarber leesbaar voor AI-agents?
Ja. Sinds september 2026 bestaat elke openbare pagina van goodbarber.com in Markdown, via de header Accept: text/markdown of door .md achter het adres te zetten, en elke HTML-pagina kondigt die versie aan met een standaardlink. De site publiceert ook een llms.txt en een llms-full.txt, die elke nacht opnieuw uit de pagina's worden gegenereerd, en elke pagina linkt ernaar.
Kan een AI-agent met een GoodBarber-app werken?
Ja, via GoodBarber MCP: een assistent zoals Claude of ChatGPT kan verbinding maken met uw app om de content ervan te lezen en te bewerken, een artikel te publiceren of een notificatie in te plannen, met uw goedkeuring. Dat is een ander onderwerp dan dit artikel, en het wordt beschreven op de pagina over GoodBarber MCP.
Lezen AI-assistenten de Markdown-versies van webpagina's?
De assistenten voor het grote publiek niet, in onze logs van september 2026. ChatGPT, Claude op het web en Perplexity hebben onze HTML-pagina's in twee weken meer dan 13.000 keer opgehaald en onze Markdown-pagina's één keer. Crawlers en codeeragents gebruikten de Markdown wel.
Helpt het serveren van Markdown bij Google?
Nee, en daar is het ook niet voor bedoeld. Onze Markdown-pagina's vragen zoekmachines om ze niet te indexeren en verwijzen terug naar de HTML-pagina. De eigen crawler van Google heeft er nooit een opgevraagd.
Moet ik een llms.txt aan mijn site toevoegen?
Het kost weinig, en crawlers lezen hem wél wanneer uw pagina's ernaar linken. In onze logs wordt hij gelezen door crawlers, directory's en SEO-tools, niet door de assistenten die vragen van mensen beantwoorden.


